KI in der Pipeline, ohne dass Code das Haus verlässt: Secupipe mit lokalem LLM
Viele Unternehmen würden KI gern Sicherheitslücken beheben lassen, schicken ihren Quellcode aber nicht an einen Cloud-Anbieter. Das müssen sie auch nicht. Der KI-Agent von Secupipe läuft auf Ihrem CI-Runner und kann mit einem Sprachmodell arbeiten, das auf Ihrem eigenen Server steht. Code, Fehlermeldungen und Prompts bleiben dann vollständig in Ihrem Netzwerk.
Wovor Unternehmen bei KI zurückschrecken
- Datenabfluss: Quellcode ist Geschäftsgeheimnis. Niemand möchte, dass er bei einem Dritten liegt oder in ein Training einfließt.
- Datenschutz: In fast jedem Repository stehen personenbezogene Daten, etwa Namen und E-Mail-Adressen in Commits, Testdaten oder Beispiele aus Kundensystemen.
- Kontrolle: Eine KI, die selbst handelt, braucht klare Grenzen und einen Menschen, der freigibt.
Ein lokales Modell beantwortet die ersten beiden Punkte technisch. Den dritten löst Secupipe schon heute: Der Agent öffnet einen Pull Request und merged nie selbst.
Was die DSGVO verlangt, wenn Code an einen KI-Anbieter geht
Sobald ein Repository personenbezogene Daten enthält, ist die Übergabe an einen KI-Dienst eine Verarbeitung durch einen Dritten. Daraus folgen Pflichten:
| Thema | KI-Anbieter in der Cloud | Lokales LLM |
|---|---|---|
| Auftragsverarbeitung (Art. 28 DSGVO) | Vertrag mit dem Anbieter nötig, Unterauftragnehmer prüfen | Entfällt für das Modell: Sie verarbeiten selbst |
| Drittlandtransfer (Art. 44 ff. DSGVO) | Bei Anbietern außerhalb der EU Rechtsgrundlage nötig, etwa Angemessenheitsbeschluss oder Standardvertragsklauseln | Findet nicht statt |
| Geschäftsgeheimnisse (§ 2 GeschGehG) | Geheimhaltung hängt an Vertrag und Einstellungen beim Anbieter | Code bleibt in Ihrer eigenen Umgebung |
| Training mit Ihren Daten | Je nach Tarif und Vertrag ausgeschlossen, muss geprüft werden | Technisch ausgeschlossen: Das Modell lernt aus Anfragen nichts dazu |
| Sicherheit der Verarbeitung (Art. 32 DSGVO) | Teilen sich Anbieter und Sie | Liegt ganz bei Ihnen |
Die letzte Zeile gehört zur ehrlichen Rechnung: Ein lokales Modell nimmt Ihnen Verträge und Transferprüfung ab, nicht die Verantwortung. Die Verarbeitung gehört weiter in Ihr Verzeichnis der Verarbeitungstätigkeiten (Art. 30 DSGVO), und der Server mit dem Modell muss abgesichert sein. Die KI-Verordnung der EU verlangt außerdem, dass Mitarbeitende, die mit KI arbeiten, dafür ausreichend geschult sind (Art. 4). Dieser Beitrag ist eine technische Einordnung und keine Rechtsberatung.
Die Architektur
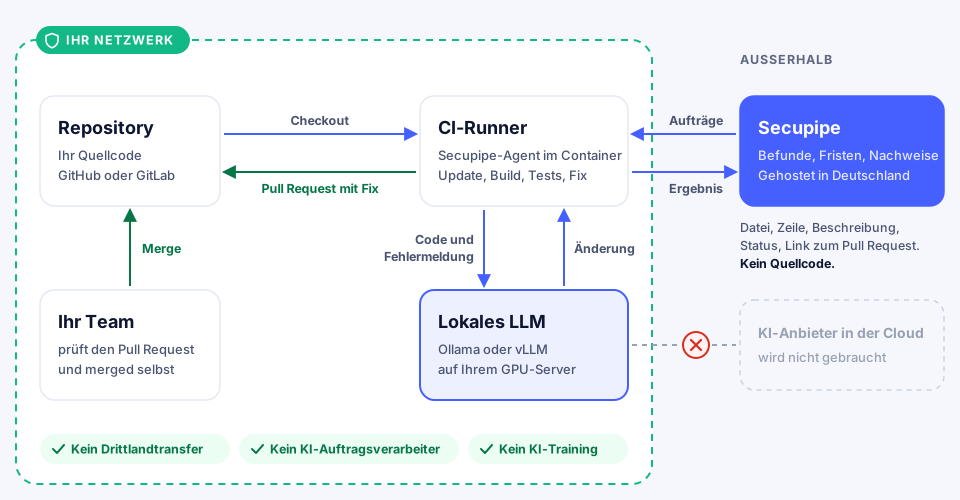
- Secupipe kennt Ihre Befunde aus den SBOMs und legt Aufträge an: Paket, Version, Sicherheitslücke.
- Der Agent auf Ihrem CI-Runner holt die Aufträge ab, checkt das Repository aus, hebt die Abhängigkeit an und lässt Build und Tests laufen.
- Bricht das Update den Build, fragt der Agent das lokale LLM. Code und Fehlermeldung gehen an Ihren eigenen Server, die Antwort kommt von dort zurück.
- Der Agent öffnet einen Pull Request. Ihr Team prüft und merged.
- An Secupipe geht nur das Ergebnis: Datei, Zeile, Beschreibung, Status und der Link zum Pull Request. Kein Quellcode.
Für den KI-Code-Scan gilt dasselbe Bild: Der Agent liest das Repository auf dem Runner, das Modell antwortet aus Ihrem Netzwerk, und Secupipe erhält nur die Befunde.
Welches Modell eignet sich?
Der Agent arbeitet in vielen kleinen Schritten: Dateien lesen, Befehle ausführen, Änderungen schreiben. Das Modell muss deshalb Werkzeugaufrufe zuverlässig beherrschen und ein großes Kontextfenster haben. Stand November 2026 kommen dafür vor allem zwei offene Modelle infrage:
| Modell | Für wen | Hardware | Lizenz |
|---|---|---|---|
| Qwen3-Coder-Next 80 Mrd. Parameter, davon rund 3 Mrd. aktiv | Unsere Empfehlung, wenn ein GPU-Server vorhanden ist. Für Coding-Agenten gebaut, 256.000 Token Kontext. | rund 48 GB Grafikspeicher oder gemeinsamer Speicher | Apache 2.0 |
| Devstral Small 2 24 Mrd. Parameter, von Mistral AI aus Paris | Der Einstieg auf kleiner Hardware. Für die typische Anpassung nach einem Versionssprung reicht es oft. | eine Grafikkarte mit 24 GB | Apache 2.0 |
Beide Modelle lösen nach Angaben ihrer Hersteller rund 70 Prozent der Aufgaben im Benchmark SWE-bench Verified. Die besten Cloud-Modelle liegen darüber, vor allem bei Änderungen, die viele Dateien betreffen. Für Secupipe ist das weniger kritisch, als es klingt: Über den Fix entscheidet nicht das Modell, sondern Ihr Build und Ihre Tests. Werden sie nicht grün, entsteht ein Pull Request als Entwurf mit dem Protokoll des Fehlers, und ein Mensch übernimmt.
Wer beides will, kombiniert: lokales Modell für Repositories mit sensiblem Code, Cloud-Modell mit europäischer Region für den Rest. Das Modell lässt sich je Pipeline festlegen.
So richten Sie es ein
Sie brauchen einen Server mit dem Modell, zum Beispiel Ollama ab Version 0.14 oder vLLM, und einen eigenen CI-Runner, der diesen Server erreicht. Der Agent spricht die Schnittstelle, die Ollama von Haus aus anbietet. In GitHub Actions:
jobs:
  autofix:
    runs-on: self-hosted # eigener Runner in Ihrem Netzwerk
    container: ghcr.io/costa-chown/secupipe-autofix:1
    steps:
      - uses: actions/checkout@v5
      - run: secupipe-autofix
        env:
          SECUPIPE_TOKEN: ${ secrets.SECUPIPE_TOKEN }
          GITHUB_TOKEN: ${ github.token }
          REPO: ${ github.repository }
          ANTHROPIC_BASE_URL: http://llm.intern:11434 # Ihr LLM-Server
          ANTHROPIC_API_KEY: lokal   # Platzhalter, wird lokal nicht geprüft
          KI_MODEL: qwen3-coder-next
          ANTHROPIC_DEFAULT_HAIKU_MODEL: qwen3-coder-next
          CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC: 1
Drei Hinweise für den Betrieb:
- Kontextfenster: Stellen Sie am LLM-Server mindestens 64.000 Token ein. Mit weniger verliert der Agent in größeren Repositories den Überblick.
- Netz: Der LLM-Server braucht keinen Zugang zum Internet und sollte nur vom Runner aus erreichbar sein.
- Probelauf: Lassen Sie den Agenten zuerst mit
DRY_RUN=1an einem unkritischen Repository arbeiten. Er pusht dann nichts und öffnet keinen Pull Request; das Protokoll zeigt, wie weit er kommt.
Wir richten das auf Wunsch mit Ihnen ein, einschließlich der Auswahl von Modell und Hardware. Wie Fix-PRs grundsätzlich funktionieren, steht im Beitrag Sicherheitslücke gefunden, Pull Request geöffnet.
Kostenlos starten Einrichtung anfragen